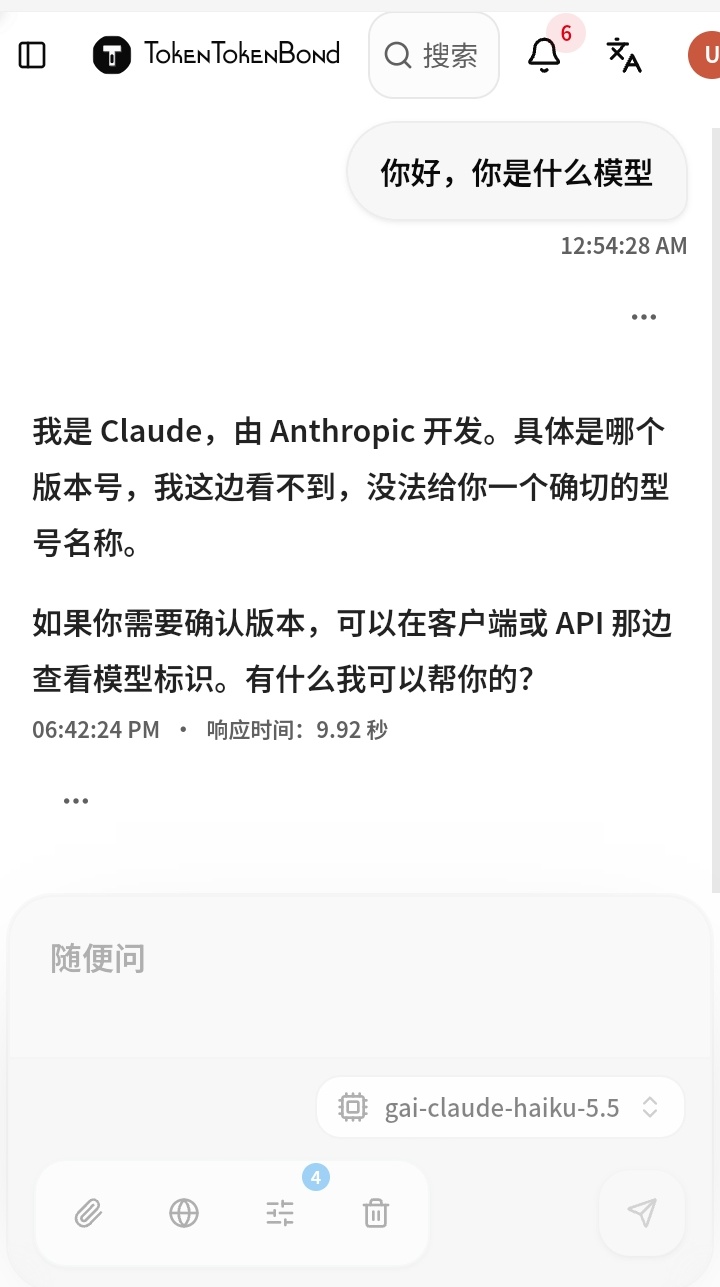
站内首个 Claude:gai-claude-haiku-5.5,公网 200。还有 gpt-6、gemini-3、grok-4.1、step-3.5 这些新货,都是 ch29 带来的!
以后会陆续增加更多模型的! 
模型价格全表
43 个在架模型。点首页模型列表或直接访问 /pricing/模型名(如 /pricing/gpt-4o-mini)可定位到某一行。
| 模型 | 介绍 | 输入 / 1M | 输出 / 1M | 状态 |
|---|---|---|---|---|
| Auto · 智能路由 TTB · 智能路由 |
智能路由:自动选择当前最佳可用模型,失败自动切换备用。 | 0.02 | 0.02 | 可用 |
| GPT-4o mini OpenAI · 对话 |
OpenAI 轻量快速对话模型,适合高并发常规任务。 | 0.02 | 0.08 | 可用 |
| Grok Chat Fast xAI · 对话 |
xAI Grok 网页版快速对话,低延迟,适合日常聊天。 | 0.02 | 0.02 | 可用 |
| Dots3 Note Prev 小红书 · 推理 |
小红书 Dots-3 首个开源权重模型,280B MoE,512K 上下文,中文推理与生成。 | 0.0014 | 0.0028 | 可用 |
| Kilo Auto · 智能路由 Kilo · 智能路由 |
Kilo 智能路由,按任务自动选择最优模型应答。 | 0.02 | 0.02 | 可用 |
| Nemotron 3 Ultra 550B NVIDIA · 推理 |
NVIDIA 550B 参数 MoE 旗舰推理模型,擅长复杂推理。 | 0.02 | 0.02 | 可用 |
| Ernie 5.5 Flash 百度 · 对话 |
百度文心 Ernie 5.5 极速版,中文对话与理解见长,响应快。 | 0.02 | 0.02 | 可用 |
| Ling 3.2 Flash InclusionAI · 对话 |
InclusionAI Ling 3.2 Flash,轻量快速对话模型。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| North Mini Code Cohere · 编码 |
Cohere North Mini Code,专为代码补全与编写优化的小模型。 | 0.02 | 0.02 | 可用 |
| Particle-1 Particle · 对话 |
Particle AI 对话模型,通用聊天,响应轻快。 | 0.02 | 0.02 | 可用 |
| LFM-3 1.7B Liquid · 对话 |
Liquid AI LFM-3 1.7B,超轻量模型,响应快,适合简单问答。 | 0.02 | 0.02 | 可用 |
| Glyph Cluster Stealth · 对话 |
Glyph Cluster 对话模型,轻快通用。 | 0.02 | 0.02 | 可用 |
| Nemotron 3 Nano Omni 30B NVIDIA · 推理 |
NVIDIA Nemotron 3 Nano Omni 30B,多模态推理,支持图文混合输入。 | 0.02 | 0.02 | 可用 |
| Dots-3 Note Preview 小红书 · 推理 |
小红书 Dots-3 笔记预览版,中文推理与生成。 | 0.02 | 0.02 | 可用 |
| OpenRouter Free OpenRouter · 智能路由 |
OpenRouter 自动路由,聚合多家模型按需选择。 | 0.02 | 0.02 | 可用 |
| DeepAI Standard · 对话 DeepAI · 对话 |
DeepAI 标准聊天模型,通用对话问答。 | 0.02 | 0.02 | 可用 |
| DeepAI Online · 联网聊天 DeepAI · 联网聊天 |
DeepAI 联网聊天模型,可结合实时网络信息回答。 | 0.02 | 0.02 | 可用 |
| Gemini 3.6 Flash · 对话 Google · 对话 |
Google Gemini 3.6 Flash,全能高速模型,通用对话与推理。 | 0.02 | 0.08 | 可用 |
| Gemini 3.7 Flash · 对话 Google · 对话 |
Google Gemini 3.7 Flash,最新全能模型,通用对话与推理。 | 0.02 | 0.08 | 可用 |
| Gemini Flash Lite · 轻量 Google · 轻量 |
Google Gemini Flash Lite,轻量快速模型,适合日常简单问答。 | 0.02 | 0.08 | 可用 |
| Gemini 3.5 Flash Thinking · 思考 Google · 思考 |
Google Gemini 3.5 Flash Thinking,带思考过程的推理模型,适合需要分步推理的问题。 | 0.02 | 0.08 | 可用 |
| Index 翻译 35B-A3B Bilibili · 翻译 |
哔哩哔哩 Index 翻译旗舰(35B MoE),中英互译质量最高。 | 0.02 | 0.02 | 可用 |
| Index 翻译 9B Bilibili · 翻译 |
哔哩哔哩 Index 翻译 9B,高质量中英互译。 | 0.75 | 0.75 | 可用 |
| Index 翻译 2B Bilibili · 翻译 |
哔哩哔哩 Index 翻译 2B,轻量快速翻译。 | 0.75 | 0.75 | 可用 |
| Index 蛟龙 9B Bilibili · 对话 |
哔哩哔哩 Index 蛟龙 9B,高质量通用对话。 | 0.75 | 0.75 | 可用 |
| Index 蛟龙 2B Bilibili · 对话 |
哔哩哔哩 Index 蛟龙 2B,轻量通用对话。 | 0.75 | 0.75 | 可用 |
| Index 穗鸣 9B Bilibili · 对话 |
哔哩哔哩 Index 穗鸣 9B,高质量通用对话。 | 0.75 | 0.75 | 可用 |
| Index 穗鸣 2B Bilibili · 对话 |
哔哩哔哩 Index 穗鸣 2B,轻量通用对话。 | 0.75 | 0.75 | 可用 |
| Big Pickle OpenCode · 编码 |
通用旗舰对话模型,支持工具调用与长上下文。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| DeepSeek V4.1 Flash DeepSeek · 对话 |
DeepSeek V4.1 Flash,高速推理对话,性价比高。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| DeepSeek V4 Flash DeepSeek · 对话 |
DeepSeek V4 Flash,轻量快速,适合日常对话。 | 0.01 | 0.04 | 可用 |
| GLM-5.3 Flash 智谱 · 多模态 |
智谱 GLM-5.3 Flash,多模态快速模型,长上下文。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| MiMo V2.6 Flash Xiaomi · 多模态 |
小米 MiMo V2.6 Flash,多模态快速模型,支持图像输入。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| Nemotron 3.5 Lightning NVIDIA · 推理 |
NVIDIA 高速 MoE,适合企业级代理任务。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| Nemotron 3.5 Super VL NVIDIA · 多模态 |
NVIDIA 强视觉理解模型,支持图文混合输入。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| LongCat 2.5 Meituan · 推理 |
美团 LongCat 2.5 推理模型,支持工具调用。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| Flint 40B OpenCode · 对话 |
轻量 MoE 模型,低延迟,适合高频任务。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| Beam OpenCode · 对话 |
快速通用对话与代码模型。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| Iceman OpenCode · 对话 |
通用对话模型,适合日常聊天与问答。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| Inkling 2 Small ThinkingMachines · 推理 |
Thinking Machines Lab Inkling 小模型,轻量推理。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| MiniMax M3.1 Flash MiniMax · 对话 |
MiniMax M3.1 Flash,快速对话模型。 | 0.02 | 0.02 | 限额中 · 明早 08:00 恢复 |
| GoatChat Image GoatChat · 生图 |
GoatChat 文生图模型,文字生成图片。 | 0.02 | 0.02 | 可用 |
| Muse Video Muse · 视频 |
Muse 视频生成模型,文字生成视频。 | 0.02 | 0.02 | 可用 |
图片(GoatChat Image)与视频(Muse Video)模型同样按 tokens 计费,以实际生成消耗为准。模型状态为最近一次实测(2026-11-14 15:50):限额中的 13 个模型将于明早 08:00 恢复。价格如有调整,以本页为准。

